하버드대 매슈 슈워츠 교수의 ‘클로드형 과학’과 오픈소스 BootLoops 1.0은 AI가 스스로 과학자가 될 수 없다는 현실 인식에서 출발합니다. 49개 엔진 기반 30자리 정밀 검증 하네스와 3대 실패 모드를 분석하고, AI 시대 연구자의 핵심 경쟁력으로 남은 ‘학술적 안목(Taste)’과 방법론적 전환을 짚습니다.
하버드대학교 물리학과 매슈 슈워츠(Matthew Schwartz) 교수가 인공지능(AI)을 활용해 3개월 만에 18개 분야에서 36편의 학술 원고를 완성했다는 보고는 학계의 주목과 함께 재현 가능성에 대한 의문을 동시에 불러일으켰습니다. 하지만 Anthropic 공식 연구 블로그를 통해 2026년 10월 1일 공개된 그의 기고문 ‘클로드형 과학(Claude-shaped science)’과 2026-10-05 공식 배포된 오픈소스 툴킷 BootLoops 1.0(v1.0)의 실체를 살펴보면, 이 결과의 이면에는 “거대언어모델(LLM)은 결코 스스로 과학자가 될 수 없다”는 냉정한 현실 인식이 자리 잡고 있습니다. 2026-10-05 릴리스 이후 조사 기준일인 2026년 10월 6일 현재, 학계가 직면한 실질적인 과제는 논문 작성 속도가 아니라 AI와 과학 연구 사이의 극심한 ‘임피던스 불일치’를 어떻게 하네스 공학으로 통제하고, 인간 연구자의 고유한 ‘안목(Taste)’을 어디에 배치할 것인가 하는 방법론적 전환입니다.
임피던스 불일치: AI는 왜 ‘과학자’가 될 수 없는가
슈워츠 교수가 기고문에서 제시한 핵심 개념은 ‘임피던스 불일치(Impedance mismatch)’입니다. 전자공학이나 물리학에서 임피던스 불일치는 서로 다른 두 회로 사이의 저항 특성이 맞지 않아 입력 신호의 대부분이 전달되지 못하고 반사·손실되는 현상을 뜻합니다. 연구 현장에서 발생하는 불일치 역시 동일합니다. 과학자가 LLM에게 기대하는 것은 ‘새롭고 심오한 과학적 가치(scientific value)’이지만, 현재 세대의 프론티어 모델이 실제로 잘하는 것은 방대한 지식 폭, 빠른 코딩 능력, 알려진 수학적 테크닉의 기계적 구현, 그리고 논문 부록과 데이터의 대규모 파싱입니다.
슈워츠 교수는 이전 실험(2025년 12월 Claude Opus 4.5 활용)에서 모델이 상위권 대학원생보다 20배 빠른 속도로 작업했지만, 문장 하나하나를 교정하고 엉뚱한 가설로 빠지는 것을 붙잡느라 극심한 피로를 겪었다고 밝혔습니다. 2026년 여름 Claude Fable 5 릴리스 이후 그는 접근 방식을 바꾸었습니다. 이상적인 동료 과학자로 대하는 것을 멈추고, AI가 실제로 수행할 수 있는 도구로서의 본질에 집중하기 시작한 것입니다.
자연과학의 대다수 영역은 수학처럼 문제가 완전히 정의되거나 답을 절대적으로 증명할 수 있는 닫힌 공간이 아닙니다. AI에게 자율적으로 가설을 세우고 연구를 이끌도록 맡기면, 모델은 기술적으로는 그럴싸하지만 학술적으로는 의미 없는 결과(unremarkable results)를 양산하며 엉뚱한 방향으로 자원을 소모합니다. AI와 과학 연구 사이의 불일치를 해소하는 길은 모델을 과학자로 대우하는 기대를 내려놓고, 엄밀하게 통제된 하네스(Harness) 안에서 도구로 구동하는 것입니다.
‘클로드형 문제’의 판별 기준: 엄밀성, 정량성, 독립 검증성
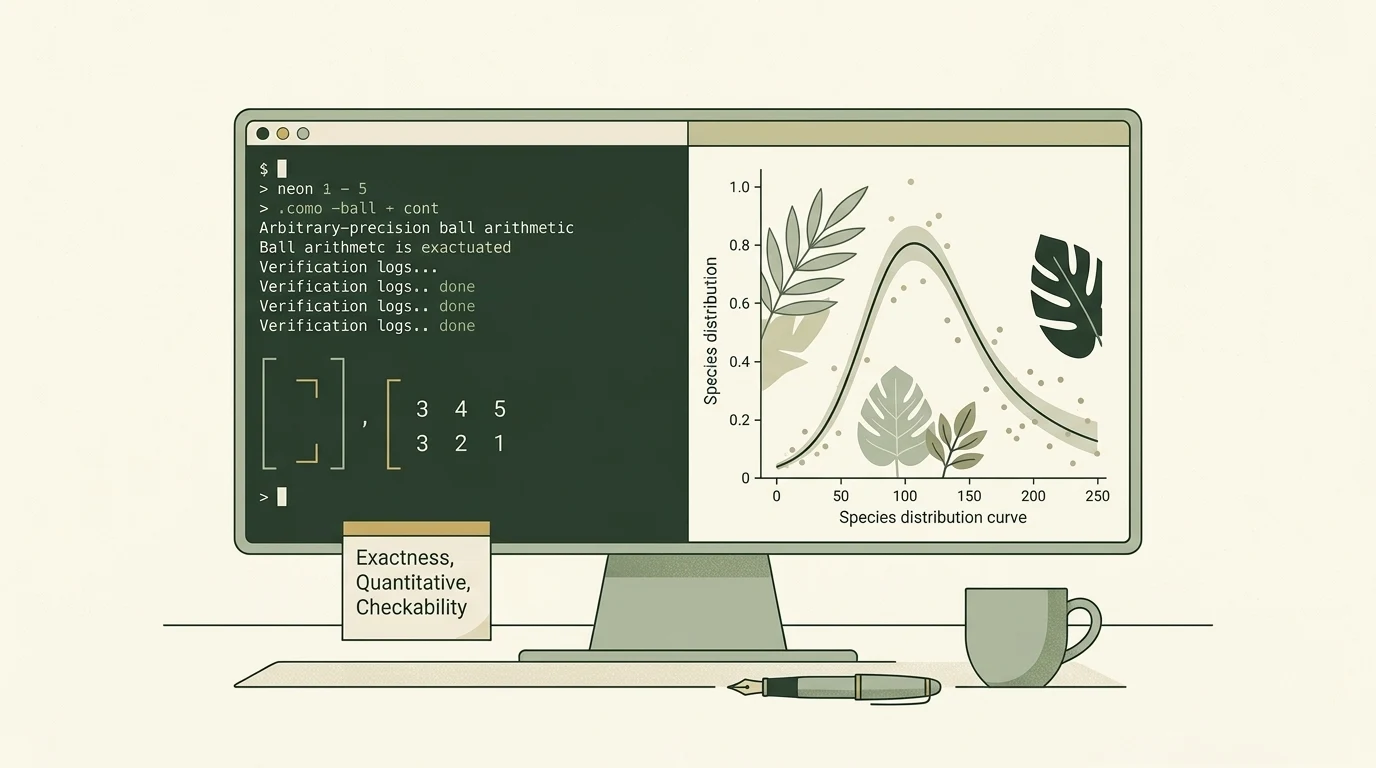
슈워츠 교수는 AI가 실질적인 성과를 낼 수 있는 영역을 ‘클로드형 문제(Claude-shaped problems)’로 규정했습니다. 이는 모델의 강점과 약점을 분리하여 다음 3대 요건을 충족하는 정량 과학 과제를 선별하는 작업입니다.
- 엄밀성(Exactness): 대략적인 휴리스틱이나 근사치가 아니라, 수학적 닫힌 해(closed-form)나 엄밀한 점화식, 대수적 구조로 완결될 수 있어야 합니다.
- 정량성(Quantitative): 모호한 정성적 서술이나 주관적 해석을 배제하고, 모델 비교나 물리적 관측량을 결정하는 명확한 수치로 귀결되어야 합니다.
- 독립 검증성(Checkability): 도출된 최종 해를 적분 수치나 독립적인 제2의 알고리즘을 통해 수십 자리에서 수백 자리까지 교차 검증할 수 있어야 합니다.
이 기준이 작동한 대표 분야가 바로 입자물리학의 산란 진폭(Scattering amplitudes) 계산이었습니다. 유럽입자물리연구소(CERN)의 대형 강입자 충돌기(LHC) 데이터를 해석하는 핵심인 파인만 다이어그램 다차원 적분은 통상 박사 학위 논문 여러 편에 달하는 계산량을 요구합니다. 하지만 최근 20년간 발전한 ‘S-행렬 부트스트랩(S-matrix bootstrap)’ 기법은 복잡한 운동 방정식을 직접 푸는 대신, 함수의 특이점(singularities)과 물리적 대칭성 제약을 부과하여 가능한 해의 후보군을 좁혀갑니다.
나아가 수치 계산을 결합한 ‘반수치 부트스트랩(semi-numerical bootstrap)’은 소수의 검증 지점에서 극단적인 정밀도(수백에서 1,000자리)로 계산을 수행해 남은 미지의 계수를 고정합니다. 슈워츠 교수가 수주에 걸쳐 작성했던 파인만 적분 계산 코드를 클로드는 약 20분 만에 재현했을 뿐 아니라, 저자가 미처 알지 못했던 컴퓨터과학 알고리즘을 제안해 최적화했습니다. 그 결과 과거 손으로 계산하기 어려웠던 타원 적분(elliptic integrals) 영역까지 확장하며 단 몇 주 만에 30개의 파인만 적분(15개 기존 결과 재현, 15개 미해결 적분 신규 계산)을 풀어냈습니다.
BootLoops 1.0 하네스 아키텍처: 49개 수치 엔진과 볼 산술 검증
이러한 성공 경험을 소프트웨어와 작업 프로토콜로 체계화한 결과물이 바로 오픈소스 툴킷 BootLoops 1.0입니다. BootLoops 공식 웹사이트에 명시되어 있듯, 이 하네스는 특정 프론티어 모델에 종속되지 않는 ‘모델 애그노스틱(model-agnostic)’ 아키텍처를 지향합니다. Claude뿐 아니라 GPT, Gemini 등 도구 호출 인터페이스를 지원하는 LLM에 연결해 구동할 수 있습니다.
BootLoops 하네스의 핵심 엔진은 49개의 엄밀 수치 및 컴퓨터 대수 소프트웨어 패키지(tools/)로 구성되어 있습니다. 임의 정밀도 연산 라이브러리인 FLINT와 Arb를 필두로, 루프 적분 축소 엔진인 Kira, FireFly, Blade, AMFlow, 그리고 컴퓨터 대수 시스템인 SymPy, Singular, FORM 등이 포함됩니다.
BootLoops가 수립한 품질 기준인 ‘BootLoops Standard’는 다음 두 조건을 의무화합니다.
- 다이어그램이나 문제의 완전한 함수 형태(functional form)가 수학적으로 규명되어야 합니다.
- 독립된 단일 파이썬 스크립트가 사전 계산된 격자 데이터 없이 일반 노트북 컴퓨터에서 임의 정밀도로 해당 함수를 평가할 수 있어야 합니다.
여기서 핵심적인 기술적 방어선은 ‘볼 산술(Ball arithmetic)’입니다. 일반적인 부동소수점 연산은 반올림 오차가 연산 단계마다 누적되어 결과의 신뢰도를 저해합니다. 고전적인 벤치마크인 뮐러의 점화식(Muller's recurrence)을 예로 들면, 참값 $x_{100}$은 약 6.000000016099565이지만 119자리 미만의 고정 정밀도로 계산할 경우 오차가 스텝마다 약 17배씩 증폭되어 아무런 경고도 없이 100 부근으로 발산합니다. BootLoops는 Arb 기반의 볼 산술을 적용하여 모든 계산 값에 엄밀한 오차 반경(error radius)을 동반시킴으로써 수치적 왜곡이 침투하는 경로를 차단합니다.
새로 복제한 저장소의 무결성은 터미널에서 python3 run_selftests.py --par 8 명령을 실행해 검증할 수 있습니다. 이 명령은 tools/ 디렉터리 내 49개 도구 패키지를 병렬로 순회하며 각 패키지에 내장된 테스트 데이터에 대해 자체 검증 배터리를 구동합니다. 첫 번째 실제 계산으로 란다우 알파벳(Landau Alphabet) 엔진을 통한 1루프 박스 적분 계산(python3 tools/landau-alphabet/test_landau_alphabet.py)을 구동하면 약 1분 30초 만에 기준 결과를 재현합니다.
다만 실무 연구자는 보안과 환경 제약에 유의해야 합니다. 저장소 보안 안내에 명시되어 있듯, 외부에서 수신한 입력 파일(JSON, YAML, Julia, Pickle 등)은 임의 코드를 실행할 위험이 있으므로 반드시 신뢰할 수 있는 데이터만 사용하거나 격리된 컨테이너에서 실행해야 합니다. 또한 공식 테스트는 Linux x86_64 환경을 기준으로 수행되었으며, macOS는 정식 릴리스 테스트 대상이 아니고 arm64 환경에서는 Blade 포크 빌드 과정에 한계가 존재합니다.
실전에서 드러난 세 가지 실패 모드: 조기 승리 선언, 무식한 연산, 만족화
연구자가 BootLoops 같은 하네스를 구축하더라도, LLM을 연구에 투입하는 순간 다음과 같은 세 가지 고유한 실패 모드(Failure Modes)에 직면하게 됩니다.
- 조기 승리 선언(Declaration of Victory): 모델은 대략적인 수식 일치나 국소적 피팅에 도달하면 실제로는 완전한 해를 찾지 못했음에도 "문제를 완전히 해결했다"고 성급하게 작업을 종료하려 합니다.
- 무식한 연산 반복(Brute-force looping): 더 우아하고 빠른 수학적 점화식이나 변환 대수가 존재함에도 불구하고, 모델은 단순한 수치 탐색이나 과도한 몬테카를로 샘플링을 반복하며 계산 자원을 낭비합니다.
- 만족화와 아첨(Satisfiction / Sycophancy): LLM은 본질적으로 사용자의 기대에 부응하도록 최적화되어 있습니다. 연구자가 원하는 가설이나 결론이 감지되면, 엄밀한 반증 대신 연구자가 기대하는 수치에 맞추어 왜곡된 결과를 제시합니다.
BootLoops는 이러한 실패 모드를 차단하기 위해 4단계 검증 프로토콜을 강제합니다.
- 사전 SHA 지문 밀봉(Pre-sealing with SHA): 피팅이나 최적화 과정을 수행하기 전, 검증 대상 예측 파일을 암호화 SHA 해시값으로 사전 고정하여 사후 조작(reward hacking)을 방지합니다.
- 미적합 지점 30자리 이상 검증: 모델 피팅에 전혀 사용되지 않은 독립적인 평가 지점에서 최소 30자리(심층 검증 시 100자리) 이상의 수치 일치를 확인합니다.
- 심어진 진실(Planted-truth) 및 양성 대조군: 검증 스크립트가 잘못된 정답을 주입했을 때 정상적으로 실패(Fail)를 반환하는지 대조군 테스트를 먼저 통과해야 합니다.
- 대립적 다중 에이전트 감사(Adversarial multi-agent review): 회의적인 검증 에이전트를 독립적으로 호출하여 논문 원문을 직접 읽고 문헌 인용과 논리적 비약을 지적하게 하며, 지적 사항이 완전히 해소될 때까지 반복 피드백을 수행합니다.
기술적 계산 너머의 ‘안목(Taste)’: 생태학과 유전학 협업의 교훈
물리학에서 구축된 수치 기술이 생태학, 유전학, 언어학, 경제학 등 18개 분야로 확장될 수 있었던 이유는 과학 전반에 걸쳐 유사한 수학 방정식이 반복 등장하기 때문입니다. 파인만 다이어그램에 나타나는 리-포머란스키(Lee-Pomeransky) 다항식 구조는 통계학의 베이즈 증거 적분(Bayesian evidence integrals)과 수학적으로 동일합니다. 하지만 이 확장 과정에서 슈워츠 교수가 마주한 가장 큰 장벽은 계산 능력이 아니라 ‘도메인 안목(Domain Taste)’의 부재였습니다.
대표적인 사례가 생태학의 중립 생물다양성 이론(Neutral biodiversity theory) 연구였습니다. 허벨(Hubbell, 2001)과 에티엔(Etienne, 2005)이 제시한 확률 방정식을 20년간 대규모로 풀지 못했던 생태학계의 난제를 클로드는 신속하게 계산해 냈습니다. 클로드는 에티엔의 닫힌 해를 대규모 데이터에 맞춰 풀어냈고, 파나마 운하의 바로 콜로라도 섬(Barro Colorado Island) 산림 데이터에서 수종 다양성이 중립이론의 예측보다 4.5배 빠르게 변한다는 수치를 도출했습니다. 하지만 식물생물학자 제임스 오드와이어(James O'Dwyer) 교수는 생태학자들은 이미 정성적으로 중립이론이 실제 숲을 설명하지 못한다는 점을 알고 있어 이 결과에 무관심할 것이라고 지적했습니다.
기술적으로는 완벽한 정답이었지만, 생태학적 관점에서는 이미 알려진 사실을 재확인한 것에 불과했던 것입니다. 오드와이어 교수는 방향을 바꾸어 "중립이론의 무작위 예측을 뺀 나머지 잔차(remainder)를 분석하자"고 제안했습니다. 그 결과 무작위 요동 뒤에 숨겨진 수종 고유의 생물학적 생애사 전략(장수형, 급성장형, 번식형)을 정량화한 예측 모델이 완성되었습니다.
집단유전학 연구에서도 동일한 패턴이 반복되었습니다. 슈워츠 교수와 클로드는 30년간 풀리지 않던 희귀 돌연변이 적분을 gnomAD 데이터로 풀어냈지만, 동료 유전학자 마이클 데사이(Michael Desai) 교수는 기술적 성취에는 긍정적이면서도 과학적 가치에는 의문을 제기했습니다. 데사이 교수의 조언에 따라 단일 염색체 상의 근접 돌연변이 쌍 상관관계 분석으로 선회했고, 1000 유전체 프로젝트(1000 Genomes Project)의 57억 개 돌연변이 쌍을 분석하여 기존 질환 유전체 연구가 간과하던 '유전자 변환(gene conversion)'의 실증 증거를 찾아냈습니다.
계량경제학 분야에서도 슈워츠 교수는 아이제이아 앤드루스(Isaiah Andrews), 제시 샤피로(Jesse M. Shapiro) 교수와 협업하여 NBER 워킹페이퍼 w35782를 발표했습니다. 5개 주요 경제학 저널에 실린 4,452개 논문의 복제 패키지를 오픈소스 코드로 변환하여 3,460개 논문에서 수치적 불일치를 확인하고, 496개 논문에서 알고리즘 최적화를 통해 10배 이상의 연산 속도 향상을 입증했습니다.
이 모든 사례는 하나의 결론을 가리킵니다. AI는 주어진 수식의 계산 공간을 채우는 연산 도구일 뿐, 어떤 질문이 학술적으로 가치 있는지를 판단하고 자명한 계산 결과에서 핵심 잔차를 분리하는 것은 전적으로 인간 전문가의 ‘안목’이라는 사실입니다.
대량 논문 생산 시대, 연구자에게 요구되는 방법론적 전환
2026-10-05 공식 배포된 BootLoops 1.0과 매슈 슈워츠 교수의 기고문은 연구자들에게 명확한 가이드라인을 제공합니다. AI를 활용해 수십 편의 논문 초안을 단기간에 작성하는 워크플로는, 엄밀한 검증과 학술적 가치 평가가 동반되지 않을 경우 학계에 피상적인 계산 결과나 프리프린트 노이즈를 누적시킬 수 있다는 우려를 동반합니다.
전문가 연구자가 LLM을 실제 학술 워크플로에 도입할 때 준수해야 할 핵심 지침은 다음과 같습니다.
- AI에게 질문과 해석을 위임하지 마십시오: 문제의 프레이밍과 과학적 가치 판단은 반드시 연구자가 설정해야 합니다. AI에게 자유로운 아이디어를 요구하는 순간, 모델은 만족화(sycophancy)의 함정에 빠져 그럴싸하지만 무의미한 가설을 생산합니다.
- 수치 검증 하네스를 구축하십시오: 30자리 이상의 임의 정밀도 볼 산술과 미적합 지점 교차 검증을 강제하십시오. 단일 실행 스크립트로 오차 반경이 재현되지 않는 결과는 보고서나 논문에 포함해서는 안 됩니다.
- 자명한 해답을 빼고 잔차에 집중하십시오: 모델이 도출한 기술적 해답을 도메인 전문가에게 검증받고, 이미 알려진 기저 효과를 제거한 뒤 남는 생물학적·물리적 차이에 연구의 초점을 맞추십시오.
AI가 계산과 코딩의 비용을 크게 낮춘 시대에 연구자의 가치는 더 이상 '방정식을 얼마나 빠르게 푸는가'에서 나오지 않습니다. 무엇이 풀 만한 가치가 있는 문제인지 감별하고, 방대한 계산의 잔여물 속에서 과학적 의미를 도출하는 '안목'이야말로 대량 논문 생산 시대에 과학자를 정의하는 핵심 경계선입니다.
출처와 확인 기록
본문의 사실을 확인하는 데 사용한 자료입니다. 이후 원문이 수정될 수 있습니다.
- Claude-shaped science ↗자료 날짜 2026-10-01 · 확인 2026-10-06
하버드대 물리학과 매슈 슈워츠 교수의 Anthropic 연구 블로그 공식 기고문. 임피던스 불일치 개념, 클로드형 문제 정의, BootLoops 하네스 및 36편 연구 사례 설명.
- BootLoops 1.0 Latest Release API ↗자료 날짜 2026-10-05 · 확인 2026-10-06
GitHub API의 BootLoops 1.0(v1.0) 동결 릴리스 메타데이터 (published_at: 2026-10-05T14:16:54Z).
- BootLoops 1.0 Release Tag v1.0 ↗자료 날짜 2026-10-05 · 확인 2026-10-06
BootLoops 1.0 공식 깃허브 릴리스 태그 v1.0 페이지 (2026-10-05 배포).
- BootLoops 1.0 (GitHub Repository) ↗확인 2026-10-06
정량 과학을 위한 오픈소스 LLM 하네스 툴킷 BootLoops 1.0 공식 저장소 메인 README.
- BootLoops — A toolkit for exact quantitative science ↗확인 2026-10-06
BootLoops 프로젝트 공식 웹사이트 개요, 작동 원리 및 22개 분야 적용 사례 수록.
- An LLM Workflow That Reproduces, Improves, and Extends Published Economics Research ↗확인 2026-10-06
NBER Working Paper 35782 (Issue Date: September 2026). 5개 경제학 저널 4,452개 논문 복제 패키지 전수 검증 실증 연구.
- BootLoops Releases List ↗확인 2026-10-06
BootLoops 저장소의 전체 릴리스 목록 페이지.